
将 PDF 转为可搜索 PDF
给扫描 PDF 添加可搜索的文字层,方便查找词句和编号。处理后在 Fylune 中预览并下载 PDF。
将 PDF 拖到这里
PDF · 仅扫描页交由 TextIn 识别
保留扫描原貌,让页面里的文字可搜索
扫描 PDF 往往只包含每页的图像。OCR 会读取没有可选文字的页面中的印刷文字,并添加不可见的文字层。阅读器可以找到这些字词,原有扫描图、图表和页序仍然保留。
- 生成结果
- 一份保留原页面外观、带可搜索文字层的 PDF。
- 校对要点
- 用 PDF 阅读器重开下载文件,搜索扫描页上看得见的一个词。
如何使用
选择文件
选择文件,或把文件拖到上传区域。
添加文字层
Fylune 识别扫描页的文字,并在原始图像上添加文字层。
校对并下载
在编辑器中确认结果,再下载副本。
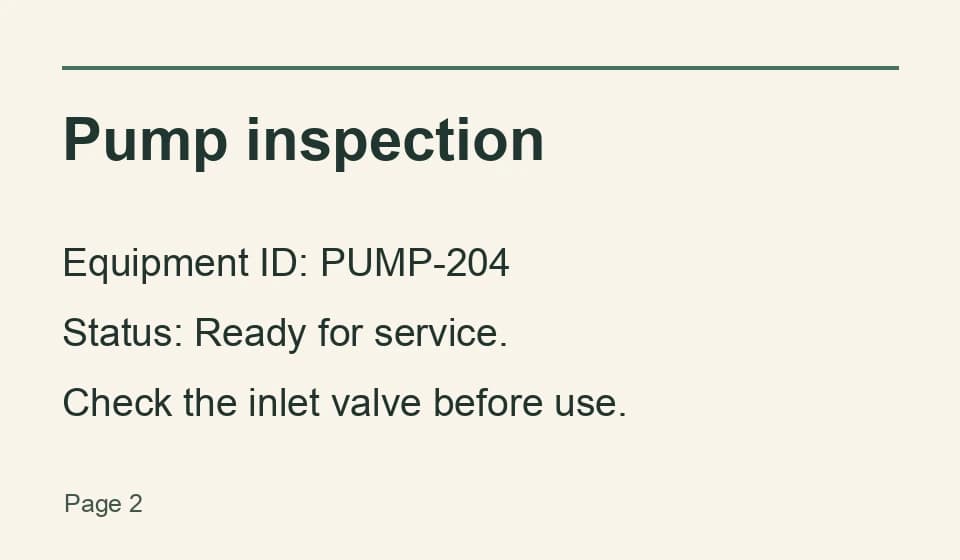
搜索结果
在第 2 页找到
Equipment ID: PUMP-204
让扫描资料更好找
- 在归档的巡检记录里查设备
- 搜索设备编号跳到对应页,再对照扫描原件检查设备状态和上下文。
- 从纸质手册里查配件
- 在转换后的 PDF 中搜索型号或部件名,同时保留原页上的图解,方便对照实物。
- 从一批收据中查找一笔支出
- 先搜索商家名称或编号,再到匹配的扫描页核实原始日期和金额。
常见问题
怎么判断 PDF 是否已经可以搜索?
可以试着选中某一页上的一个单词,或者用阅读器搜索。若整页只能作为一张图片选中,就可能需要 OCR。
OCR 会改变页面外观吗?
文字层不可见,扫描图、可见标记和图表仍在原处。下载转换后的文件就能保留新增的文字层。
一份 PDF 里只有几页是扫描件怎么办?
Fylune 保留已有的可选文字,只对没有可选文字的页面运行 OCR。已有文字的页面里,附带的图片可能仍然无法搜索。
可以转换加密或数字签署过的 PDF 吗?
请选择未加密且有权修改的副本。已数字签署的文件如果需要修改以添加文字层,会被拒绝。
一次最多能转换多少页?
一个 PDF 最多 100 页,其中最多 20 页需要 OCR。空白或模糊的扫描页仍可能没有可搜索文字。