
PDF 转文本
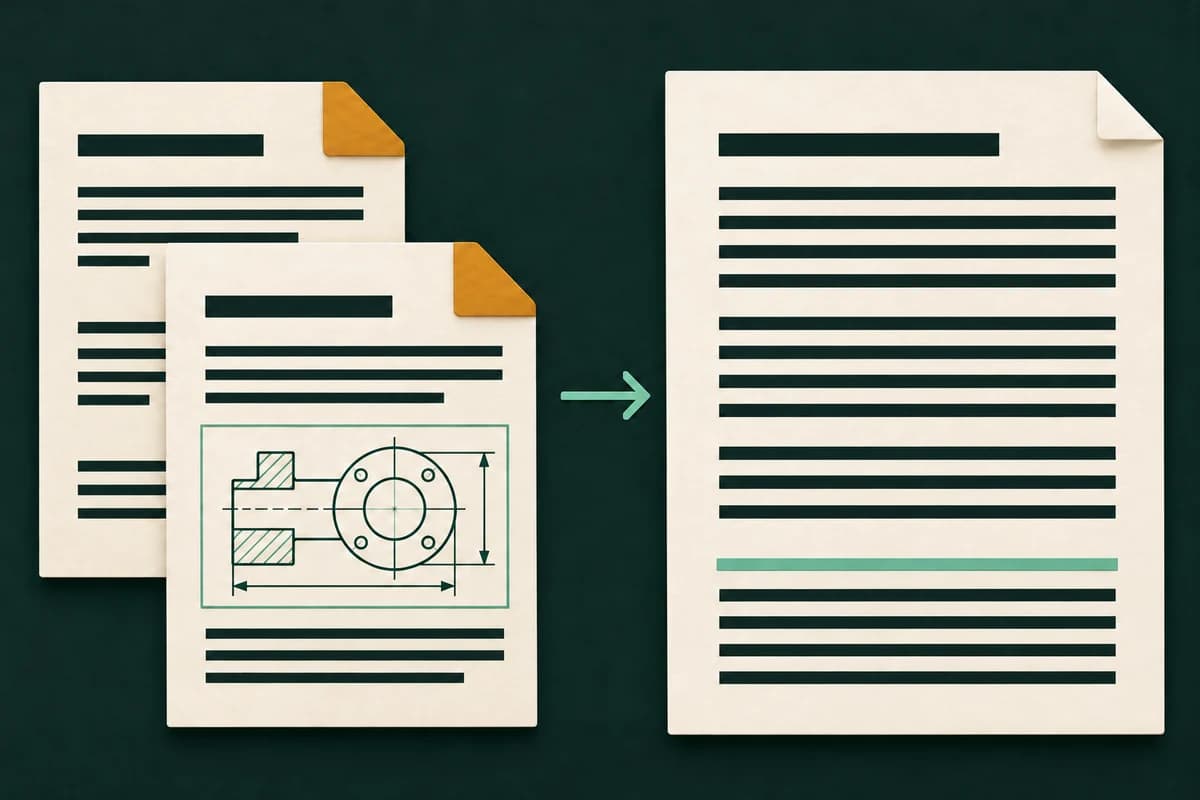
把 PDF 内容转成可复用的纯文本。Fylune 提取已有文字,对扫描页做 OCR,再打开编辑器供你校对和下载 .txt。
将 PDF 拖到这里
PDF · 仅扫描页交由 TextIn 识别
把 PDF 里的文字单独提出来
普通 PDF 中已有的文字会直接提取。遇到没有可选文字的扫描页,Fylune 会用 OCR 识别多语言印刷文字。结果是独立的可编辑文本,能粘贴到其他应用里使用。
- 生成结果
- 可编辑的 UTF-8 纯文本,不保留图片、分栏和表单位置。
- 校对要点
- 复用前检查多栏页面的阅读顺序,并核对段落换行。
如何使用
选择文件
选择文件,或把文件拖到上传区域。
提取文字
Fylune 提取已有文本,对没有可选文字的页面运行 OCR。
校对并下载
在编辑器中确认结果,再下载副本。
文本结果
Visitor check-in
Front desk opens at 8:30 AM.
Bring a printed entry pass.
Use the east entrance.
把 PDF 里的内容用到其他地方
- 引用手册中的一段话
- 提取文字后与 PDF 对照,只复制需要引用的段落。原 PDF 可以留作页码参考。
- 转录扫描版信件
- 将清晰的扫描件转为纯文本,分享之前核对姓名、日期和段落换行。
- 另存报告的文字版本
- 下载 .txt 进行笔记、编辑或搜索。需要查看表格或版式时,保存原 PDF 备查。
常见问题
普通 PDF 和扫描 PDF 都能转换吗?
都可以。Fylune 直接提取原本就能选中的文字,在无可选文字的页面上使用 OCR。OCR 支持中英混排等多语言文字。
TXT 会保留原来的分栏或表格吗?
纯文本保存文字和换行,无法保留分栏、图片或表单位置。原文有多栏时,建议检查提取结果的阅读顺序。
PDF 转文本和可搜索 PDF 有什么区别?
PDF 转文本给你一份独立的 .txt 文件,方便修改和复制。可搜索 PDF 保留原来的页面,并加入阅读器能搜索的文字层。
怎么复制或下载结果?
在编辑器里先校对,然后点击复制文字或下载。下载的格式为 UTF-8 .txt。
可以处理长文档吗?
一次处理一个 PDF,最多 100 页,其中需要 OCR 的页面最多 20 页。更长的扫描件可以先拆分再转换。